
Do porządkowania firmowej skrzynki użyłem małego polskiego modelu decyzyjnego Basal (1,5 mld parametrów) uruchomionego lokalnie na karcie NVIDIA Tesla T4. Model nie pisze tekstu. Dostaje treść maila i zamknięte pytania („do jakiej kategorii należy?”, „czy trzeba coś zrobić?”), a odpowiada rozkładem prawdopodobieństwa. Pierwszy przebieg zmniejszył skrzynkę odbiorczą z 638 do 200 wiadomości, a liczbę nieprzeczytanych z 527 do 145. Decyzja na podstawie pięciu pytań zajmuje w medianie 0,62 s. Najważniejszy wniosek jest jednak inny: model działa najlepiej razem z prostymi regułami deterministycznymi, a nie zamiast nich.

Basal i porządkowanie skrzynki pocztowej
Problem: kilkadziesiąt maili dziennie, głównie od maszyn
Zajmuję się infrastrukturą IT. Do mojej firmowej skrzynki przychodzi średnio 61 nowych wiadomości dziennie już po usunięciu tych zbędnych (1706 wiadomości w czterech tygodniach, od 14 września do 11 października 2026). Większość wysyłają maszyny: Zabbix zgłasza problem, po kilku minutach przysyła „Resolved”, backup melduje sukces, a do tego dochodzą powiadomienia z systemu kadrowego, intranetu i paneli dostawców. Między nimi giną wiadomości od ludzi: współpracowników, klientów i dostawców.
Klasyczne filtry w kliencie pocztowym pomagały do pewnego stopnia. Miałem je w Betterbirdzie, więc działały tylko na komputerze, na którym były skonfigurowane. Co gorsza, filtr nie odróżni alertu „Problem: dysk pełny”, który wciąż trwa, od tego samego alertu, który dawno się rozwiązał.
Postanowiłem sprawdzić, czy mały, lokalnie uruchomiony model decyzyjny poradzi sobie z codziennym porządkowaniem poczty. Interesowało mnie przy tym, ile to kosztuje w czasie i sprzęcie oraz gdzie model zawodzi. Ten tekst to zapis tego eksperymentu, z liczbami.
Czym jest Basal
Basal to rodzina modeli autorstwa Remigiusza Kinasa, opublikowana na licencji Apache-2.0 i przeznaczona do typowanych decyzji po polsku i angielsku. Autor odwołuje się do „Systemu 1”, czyli szybkiego, intuicyjnego trybu myślenia. Model nie prowadzi rozmowy i nie generuje tekstu. Dostaje stan (u mnie treść maila), pytanie i listę dopuszczalnych odpowiedzi, a zwraca prawdopodobieństwo każdej z nich. Odpowiedź nigdy nie wychodzi poza podane opcje. Dla automatu to cecha kluczowa: nie trzeba parsować wolnego tekstu ani bronić się przed „kreatywnością” modelu.
Basal obsługuje kilka typów pytań. Ja użyłem trzech:
| Typ | Co zwraca | Przykład z mojego bota |
|---|---|---|
choice | jedną opcję z listy i rozkład prawdopodobieństwa | kategoria maila (9 opcji) |
noul | prawdopodobieństwo odpowiedzi „tak” | czy odbiorca musi coś zrobić? |
score | rozkład na uporządkowanej skali i wartość oczekiwaną | pilność: niska / normalna / pilna |
Są jeszcze multi (kilka etykiet naraz) i act (wybór akcji o najniższym oczekiwanym koszcie według macierzy kosztów). Kolejność opcji ma znaczenie przy pytaniach score, bo wyznacza skalę od najniższego poziomu, więc klient musi ją zachować (w Go zwykła mapa jej nie gwarantuje). Serwer basal-serve zadaje każde pytanie dwa razy, z opcjami w kolejności oryginalnej i odwróconej, a następnie uśrednia wyniki. Dzięki temu model mniej faworyzuje opcje z początku listy, co ma znaczenie przy dziewięciu kategoriach.
Używam najmniejszego wariantu, basal-1.5-mini (1,5 mld parametrów, dostrojony z Bielika 1.5B), w kwantyzacji Q4_K_M. Plik modelu waży około 1 GB.
Sprzęt
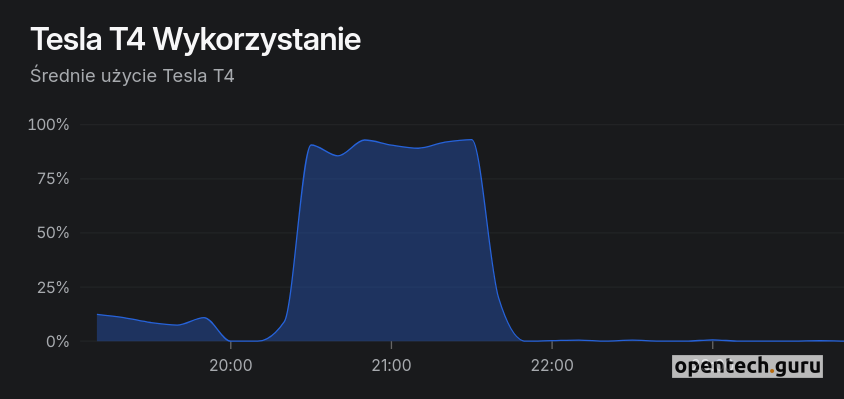
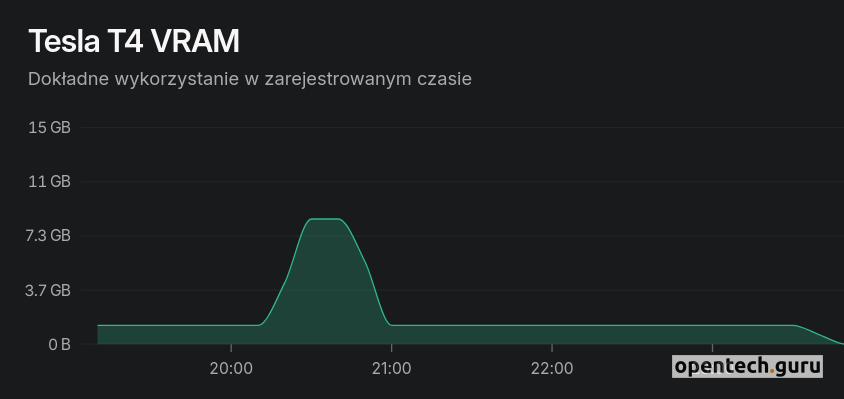
Basal działa lokalnie, na maszynie wirtualnej w Proxmoxie z kartą NVIDIA Tesla T4 (16 GB VRAM) przekazaną do VM przez passthrough. Treść poczty nie opuszcza więc firmowej sieci. Na tej samej karcie pracują też dwa modele czatowe, Bielik 11B i Qwen 2.5 7B. Basal zajmuje z tego tylko około 1,2 GB pamięci karty. Pośrednikiem jest Ollama, która liczy prawdopodobieństwa pojedynczego tokenu, a dostęp do API chroni token, jak w przypadku pozostałych modeli.
Architektura: najpierw reguły, potem model
Bot, nazwany przeze mnie KKMailBot, jest niewielką usługą w Go. Co dwie minuty łączy się ze skrzynką przez IMAP, pobiera nowe wiadomości i każdą przepuszcza przez trzy etapy.
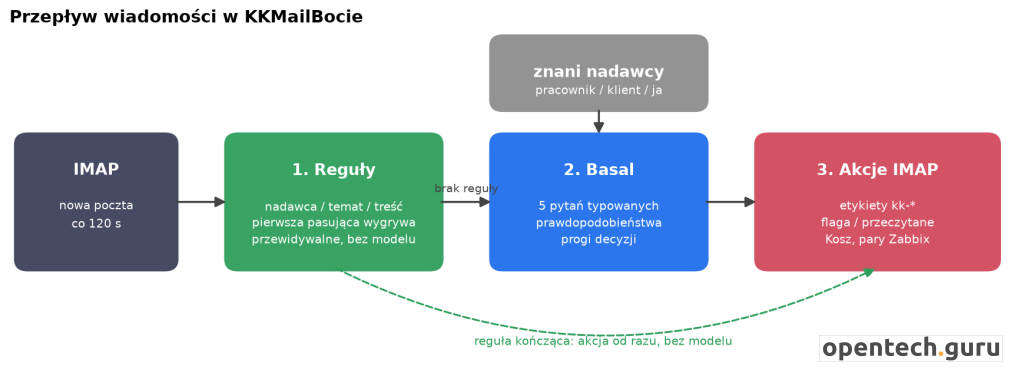
- Reguły deterministyczne. Warunki typu „nadawca kończy się na…”, „temat zawiera…”. Pierwsza pasująca reguła wygrywa. Reguła kończąca wykonuje akcję od razu i maila nie widzi już model.
- Basal. Dostaje wiadomości, których nie obsłużyła żadna reguła kończąca. W jednym zapytaniu pada pięć pytań, a w drugim, krótkim, pytanie o zaproszenie na spotkanie. Z odpowiedzi i progów bot układa plan: etykiety, flagę, oznaczenie jako przeczytane albo przeniesienie do Kosza.
- Akcje IMAP. Etykiety zapisuję jako słowa kluczowe IMAP (
kk-alerty,kk-do-zrobienia…), więc działają w każdym kliencie i po zmianie komputera. Osobny, deterministyczny krok łączy pary Zabbixa (o nim niżej).
Ważna decyzja projektowa: wszystkie filtry przeniosłem do bota. Filtry w Betterbirdzie wyłączyłem, a na serwerze poczty nie mam żadnych. Gdy kiedyś zmienię klienta albo serwer poczty, logika porządkowania zostanie w jednym miejscu.
Co Basal widzi
Do modelu trafia nagłówek (od, do, temat, nazwy załączników) i treść bez cytowanej historii, ucięta do 4000 znaków. Ucinanie cytatów ma duże znaczenie: odpowiedź „OK, dzięki” nad trzema ekranami przekazanej korespondencji to inna wiadomość niż ta korespondencja.
Pięć pytań
Wszystkie pytania idą w jednym zapytaniu HTTP:
{
  "state": "Od: ...\nTemat: ...\n\n<treść>",
  "questions": {
    "kategoria": {
      "type": "choice",
      "instructions": "Do jakiej kategorii należy ta wiadomość e-mail?",
      "criteria": {
        "faktury": "Faktury, rachunki, płatności, przypomnienia o zapłacie, sprawy księgowe",
        "alerty": "Automatyczne alerty i raporty systemów IT: Zabbix, iDRAC, Proxmox, Ceph, backupy, monitoring, logi, podatności",
        "inne": "Tylko wiadomości, które zdecydowanie nie pasują do żadnej z pozostałych kategorii"
      }
    },
    "wymaga_dzialania": { "type": "noul",
      "instructions": "Czy odbiorca musi coś zrobić w związku z tą wiadomością: odpowiedzieć, zatwierdzić, zapłacić, pomóc, naprawić? Odpowiedz nie, jeśli wiadomość jest tylko informacją." },
    "pilnosc":  { "type": "score", "criteria": { "niska": "...", "normalna": "...", "pilna": "..." } },
    "zdarzenie": { "type": "choice", "criteria": { "problem": "...", "rozwiazanie": "...", "raport": "...", "informacja": "..." } },
    "waga":     { "type": "score", "instructions": "Jaki jest OBECNY stan systemu według tej wiadomości?",
                  "criteria": { "sprawny": "...", "ostrzezenie": "...", "awaria": "..." } }
  }
}
(Lista kategorii jest skrócona. Pełna obejmuje: faktury, zamówienia, klienci, wewnętrzne, alerty, powiadomienia, newsletter, spam, inne.)
Tak wygląda odpowiedź dla typowego alertu „Problem”:
"kategoria": { "choice": "alerty", "confidence": 0.61,
               "probabilities": { "alerty": 0.61, "inne": 0.32, "klienci": 0.02, ... } },
"zdarzenie": { "choice": "problem", "confidence": 0.97 },
"waga":      { "score": 0.52, "probabilities": { "sprawny": 0.72, "ostrzezenie": 0.03, "awaria": 0.25 } },
"pilnosc":   { "probabilities": { "niska": 0.28, "normalna": 0.09, "pilna": 0.63 } },
"wymaga_dzialania": { "noul": 0.11 }
Pytanie wymaga_dzialania nadal jest zadawane, ale od wersji 0.3.0 trafia tylko do logu. Dlaczego, wyjaśniam w części o trafności.
Ten przykład dobrze pokazuje, po co zadawać kilka pytań. Kategoria jest niepewna (61%, a „inne” dostaje 32%), ale pytanie o zdarzenie nie zostawia wątpliwości: to zgłoszenie problemu (97%). Dlatego dla alertów obniżyłem próg kategorii do 40%: o tym, co zrobić z alertem, i tak decyduje pytanie o zdarzenie.
Zaproszenia na spotkania
Zaproszenia z kalendarza (Nextcloud, Google, Outlook) mają część text/calendar z polem METHOD. Jest w nim zapisane, czy to nowe zaproszenie (REQUEST), odwołanie (CANCEL) czy odpowiedź (REPLY). Tego nie trzeba zgadywać, więc obsługuje to kod: zaproszenie dostaje kk-spotkania, a nowe zaproszenie dodatkowo kk-do-zrobienia i flagę.
Zaproszenia pisane zwykłym tekstem („zapraszam na spotkanie organizacyjne we wtorek o 10:00”) rozpoznaje Basal osobnym pytaniem „czy ta wiadomość zaprasza na spotkanie?”. Ciekawy szczegół: dla jednozdaniowego zaproszenia z długą firmową stopką model dawał 3%, a po odcięciu stopki 87%. Stopka z adresem, numerami telefonów i klauzulą RODO zagłuszała treść. Pytanie o spotkanie dostaje więc tekst bez stopki. Pytania o kategorię dostają tekst pełny, bo na 336 mailach odcięcie stopki nie poprawiło trafności (76 = 76), a zwiększyło liczbę niepewnych odpowiedzi (141 → 173). Dodatkowe zapytanie kosztuje około 0,2 s na mail.
Progi, czyli gdzie kończy się model, a zaczyna polityka
Model zwraca prawdopodobieństwa, a decyzję podejmuje kod. Wszystkie progi są w jednym miejscu:
| Decyzja | Warunek |
|---|---|
| etykieta kategorii | pewność ≥ 0,60 (alerty: ≥ 0,40), inaczej kk-niepewne |
kk-do-zrobienia (+ flaga) | od 0.3.0 bez modelu: nadawca i wątek (opis niżej) |
kk-pilne + flaga | P(pilna) ≥ 0,60 |
kk-spotkania (bez flagi) | P(zaproszenie na spotkanie) ≥ 0,80 |
| newsletter → przeczytane | pewność ≥ 0,85 |
| alert OK → przeczytane | P(rozwiązanie + raport) ≥ 0,90 i P(awaria) < 0,10 |
| spam → Kosz | pewność ≥ 0,97 |
Progi są asymetryczne celowo. Oznaczenie maila jako przeczytany albo przeniesienie go do Kosza jest kosztowne, jeśli okaże się pomyłką, więc wymaga bardzo wysokiej pewności. Dodanie etykiety nic nie kosztuje, więc wystarcza umiarkowana pewność. Przy spamie ustawiłem próg 0,97: wolę przeczytać kilka reklam niż przegapić fakturę.
Reguły deterministyczne: kiedy nie pytać modelu
Model językowy kusi, żeby wrzucić do niego wszystko. W praktyce warto najpierw zapytać, czy odpowiedź jest znana z góry. Jeśli tak, reguła jest szybsza, darmowa, w 100% przewidywalna i daje się wytłumaczyć w jednym zdaniu. W bocie mam cztery rodzaje takich reguł.
1. Reguły z panelu. Jedenaście reguł, np. „powiadomienia systemów, które nie wymagają akcji → przeczytane i do Kosza” czy „marketing konkretnych dostawców → Kosz”. Przeniosłem je z dawnych filtrów Betterbirda. Pewne powiadomienia zawsze wyglądają tak samo, więc pytanie o nie modelu to strata czasu i ryzyko pomyłki.
2. Znani nadawcy. Kategoria często wynika z adresu, a nie z treści:
- adres pracownika (wzorzec
inicjał.nazwisko@firma) dostaje etykietękk-pracownicy, obok kategorii wybranej przez Basala; - domena znanego klienta dostaje zawsze
kk-klienci, niezależnie od zdania modelu; - moje prywatne konto dostaje
kk-ja(czasami wysyłam sobie zadania emailem z telefonu); - mail od znanego nadawcy nigdy nie trafia do Kosza, nawet gdy model uzna go za spam. Werdykt „spam” przy adresie współpracownika to niemal na pewno pomyłka modelu.
Listę domen klientów i prywatnych adresów mogę edytować w panelu ustawień. Kusiło mnie, żeby zamiast tego podawać listę domen modelowi w opisie kategorii „klienci”. Zrezygnowałem: porównanie tekstu daje pewność, a model tylko prawdopodobieństwo. Do tego dłuższe opisy kategorii w moich testach obniżały trafność (o tym niżej).
3. Parowanie alertów Zabbixa. Basal ocenia, czy alert „Resolved” oznacza powrót do normy. Natomiast to, który problem zamyka, odczytuje kod z pola Original problem ID w treści. Kod zdejmuje wtedy flagę z problemu, oznacza oba maile jako przeczytane i przenosi parę do Kosza. Tego nie zostawiłbym modelowi: identyfikator albo się zgadza, albo nie.
4. Do zrobienia: nadawca i wątek. Mail dostaje kk-do-zrobienia, gdy jest:
- notatką do siebie, wysłaną z mojego prywatnego adresu (z flagą);
- odpowiedzią człowieka na mój mail (z flagą). Bot rozpoznaje ją po nagłówkach
In-Reply-ToiReferences, porównując je z identyfikatoramiMessage-IDz folderu Wysłane, których trzyma w bazie około 3,7 tysiąca; - wiadomością do mnie (pole Do, nie DW) od pracownika albo klienta (bez flagi).
Poczta masowa i automatyczna (nagłówki List-Unsubscribe, Auto-Submitted, nadawcy noreply@) nigdy nie dostaje tej etykiety. Dlaczego reguła, a nie model, pokazuje sekcja o trafności.
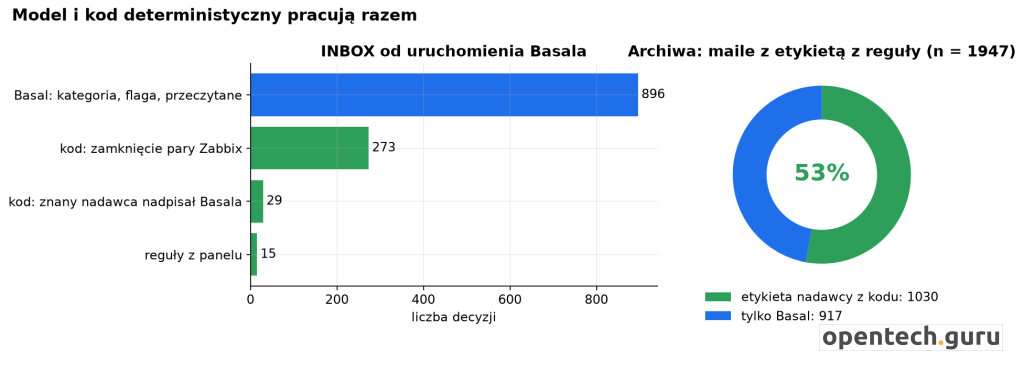
Wykres pokazuje podział pracy. W bieżącej skrzynce Basal podjął 896 decyzji, a kod zamknął na ich podstawie 273 pary Zabbixa. W archiwach 53% maili dostało etykietę nadawcy z reguły, bez udziału modelu. Reguły z panelu miały w tym oknie tylko 15 trafień. Obsługują wąskie, przewidywalne przypadki, więc ich zaletą jest pewność, a nie liczba.
Wyniki
Liczby w tej części pochodzą z wersji sprzed 0.3.0, w której etykietę „do zrobienia” nadawał jeszcze Basal.
Pierwszy przebieg po skrzynce odbiorczej
Po wdrożeniu bot sklasyfikował całą zawartość skrzynki odbiorczej, czyli 638 wiadomości zaległych z kilku tygodni.
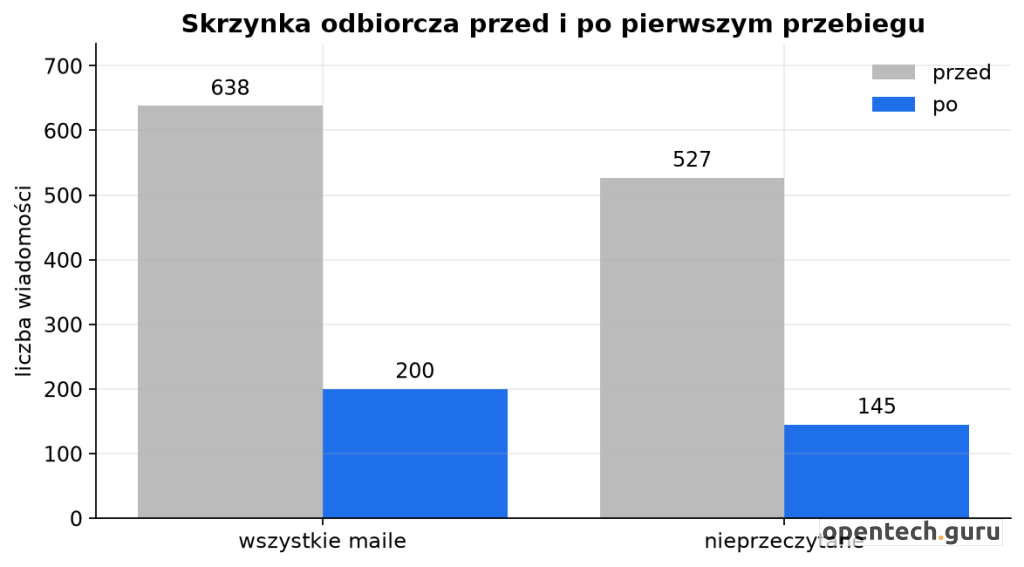
- 638 → 200 wiadomości w skrzynce odbiorczej. 252 zakończone problemy Zabbixa i 219 odpowiadających im „Resolved” trafiło do Kosza (jeden „Resolved” potrafi zamknąć kilka zgłoszeń).
- 527 → 145 nieprzeczytanych.
- 27 wiadomości z flagą: 14 trwających problemów bez pary oraz sprawy oznaczone jako pilne lub do zrobienia.
- 0 błędów akcji IMAP. Trzy zapytania do Basala przekroczyły limit 15 s, bo w tym samym czasie na karcie trwało etykietowanie archiwum. Bot zostawia takie wiadomości w kolejce i ponawia je w następnym cyklu, więc nic nie przepadło.
Dwie różne skrzynki
Żeby sprawdzić model na szerszym materiale, przepuściłem przez niego także archiwum z lat 2019–2026: 13 folderów i 2156 wiadomości. Tym razem bot tylko nadawał etykiety, bez flag i bez przenoszenia. Rozkład kategorii okazał się zupełnie inny niż w bieżącej skrzynce:
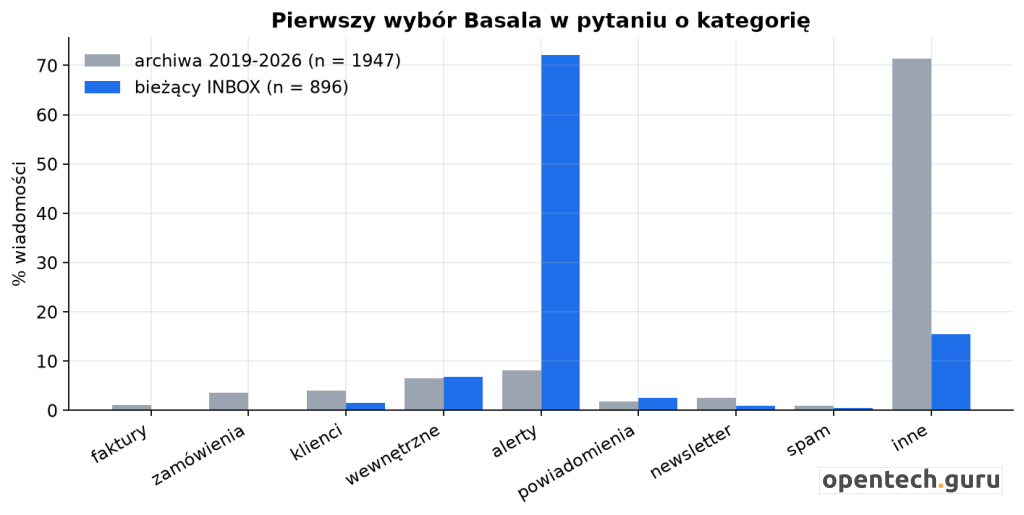
W bieżącej skrzynce 72% wiadomości to alerty, a w archiwum, które z definicji zawiera to, co uznałem za warte zachowania, dominuje korespondencja z ludźmi. To rozróżnienie wraca we wszystkich kolejnych pomiarach.
Jak pewny jest model
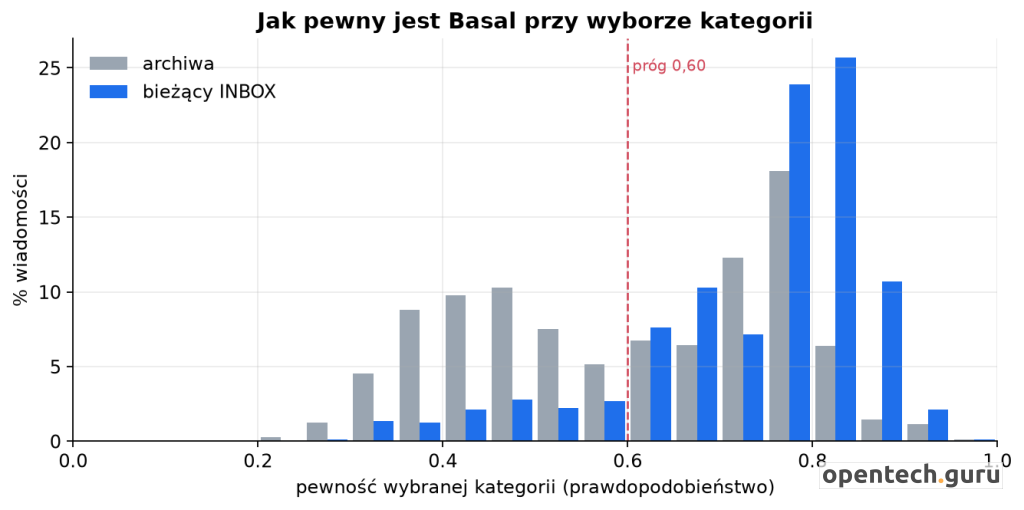
Mediana pewności kategorii wynosi 0,78 w bieżącej skrzynce i tylko 0,62 w archiwum. Alerty i powiadomienia są do siebie podobne i mają wyraźne słowa kluczowe, więc model jest ich pewny. Korespondencja między ludźmi o sprawach technicznych („podeślij konfigurację tego przełącznika”) nie pasuje dobrze do żadnej z dziewięciu szuflad. Model to sygnalizuje: rozkład jest płaski, a zwycięska opcja ma 40–55%.
Widać to także w podziale na kategorie (mediana pewności w archiwum):
| Kategoria | Maile | Mediana pewności |
|---|---|---|
| faktury | 22 | 0,74 |
| alerty | 158 | 0,67 |
| inne | 1391 | 0,65 |
| newsletter | 49 | 0,63 |
| wewnętrzne | 126 | 0,51 |
| zamówienia | 70 | 0,47 |
| klienci | 79 | 0,45 |
Faktury i alerty model rozpoznaje pewnie. Najsłabiej wypada przy „klientach” i „zamówieniach”, czyli tam, gdzie granica zależy od kontekstu biznesowego, którego model nie zna. To kolejny argument za regułą „znana domena klienta → kk-klienci”.
Cena ostrożności
Próg pewności to suwak między dwiema stratami: przy zbyt niskim etykiety bywają błędne, przy zbyt wysokim większość maili dostaje kk-niepewne. Sprawdziłem, jak próg przekłada się na odsetek maili bez kategorii:
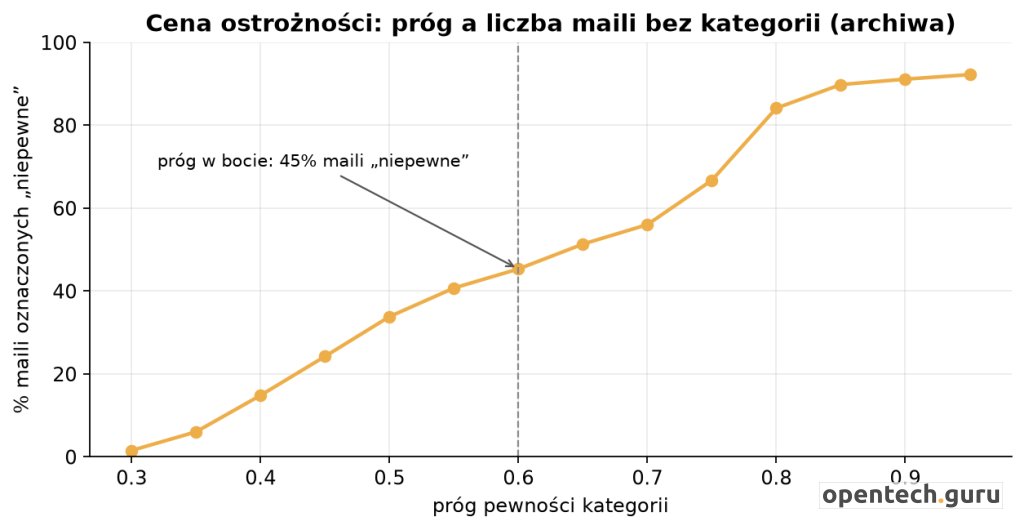
Przy progu 0,60 w archiwum bez kategorii zostaje 45% maili. Ostateczny udział etykiety kk-niepewne jest niższy (41%), bo moje prywatne konto i domeny klientów dostają etykietę z reguły. Krzywa ma dwa załamania: przy 0,45–0,50 i przy 0,75–0,80. Powyżej 0,80 prawie nic nie przechodzi. W bieżącej skrzynce, gdzie przeważają alerty, ten sam próg daje etykietę kk-niepewne tylko 8% maili (71 z 896).
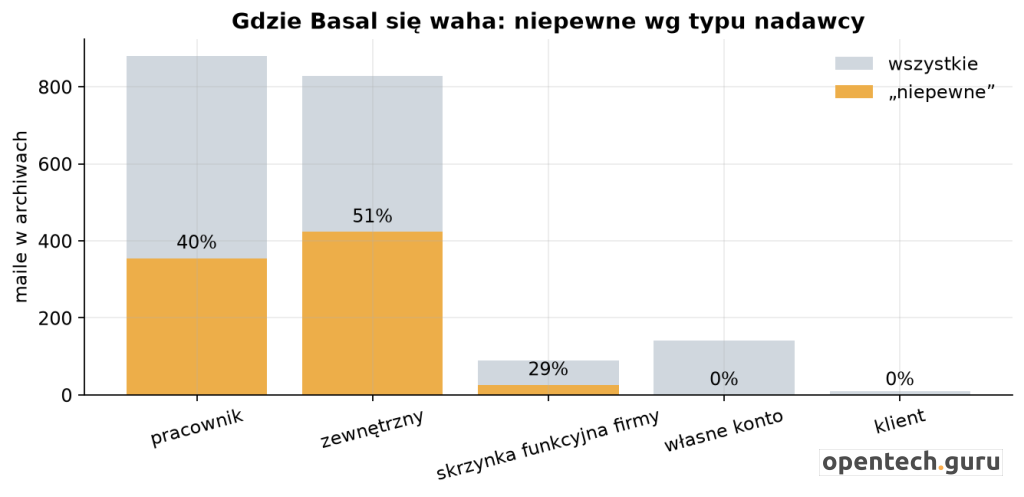
Model najbardziej waha się przy korespondencji z zewnątrz (51% niepewnych) i od współpracowników (40%). U współpracowników nie jest to problem, bo i tak dostają etykietę kk-pracownicy. Taki mail ma więc znaczącą etykietę, nawet gdy model nie umie go zakwalifikować.
Opisy kategorii mają znaczenie
Najciekawszy wynik dotyczył treści zapytania. Na 99 mailach z jednej doby porównałem pięć wersji opisów kategorii, przy tym samym modelu i tych samych wiadomościach. Za wzorzec przyjąłem kategorię wynikającą z nadawcy, np. skrzynka monitoringu oznacza alerty. To przybliżenie, nie ręczna ocena, ale wystarcza do porównania wariantów.
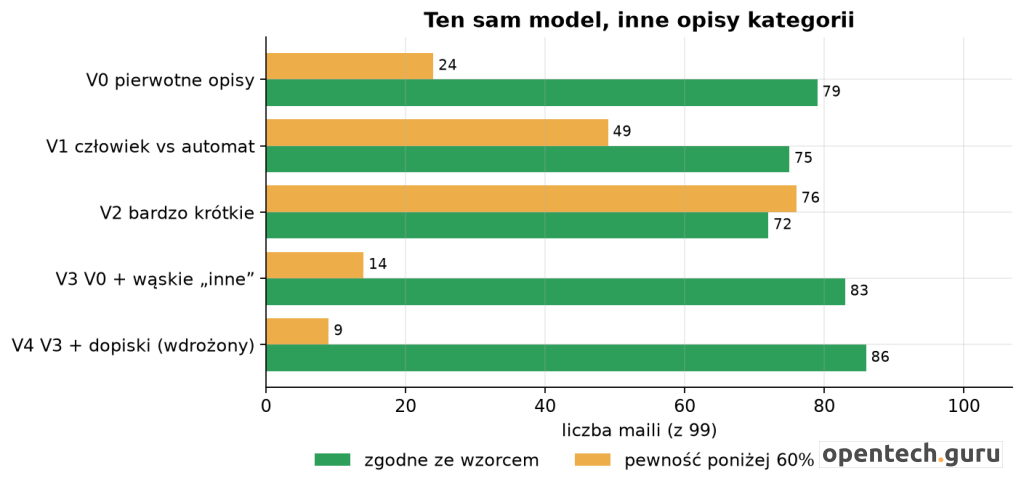
- V1, opisy rozróżniające „pisane przez człowieka” i „wysłane przez automat”, pogorszył wynik: 75 zamiast 79 trafień.
- V2, bardzo krótkie hasła, wypadł najgorzej: 72 trafienia, a 76 z 99 odpowiedzi miało pewność poniżej 60%. Model potrzebuje kilku słów kontekstu.
- V3: wystarczyło zawęzić kategorię „inne” do „tylko wiadomości, które zdecydowanie nie pasują do żadnej z pozostałych”. Wynik wzrósł do 83, a liczba niepewnych odpowiedzi spadła z 24 do 14.
- V4, czyli V3 plus kilka słów (np. „spotkania”, „podatności”, „kalendarz”), dał 86 trafień i 9 niepewnych. Tę wersję wdrożyłem.
Wniosek praktyczny: opisy kategorii to zwykły kod i trzeba je testować na własnych danych. Dłuższe opisy, z przykładami konkretnych systemów, obniżały trafność małego modelu. Najbardziej pomogło zawężenie kategorii „inne”, która domyślnie zbierała wszystko, co niejasne.
Trafność według człowieka
Ze skrzynki wylosowałem 100 wiadomości: 60 z archiwum i 40 z bieżącej skrzynki. Każdą przejrzałem ręcznie: arkusz zawierał kategorię zaproponowaną przez Basala, a ja poprawiałem ją tam, gdzie się nie zgadzałem. Taka ocena jest szybsza, ale może sprzyjać modelowi, bo łatwiej przyjąć gotową odpowiedź niż wskazać ją samemu.
- Trafność kategorii: 82% (82 ze 100). W bieżącej skrzynce 97,5% (39 z 40), w archiwum 71,7% (43 z 60).
- Przy progu 0,60 bot sam zdecydował o 70% maili, z trafnością 88,6%. Pozostałe 30% dostało
kk-niepewne. - Wszystkie 18 pomyłek miało pewność poniżej 0,80. Powyżej tego progu (22 maile) nie było ani jednej.
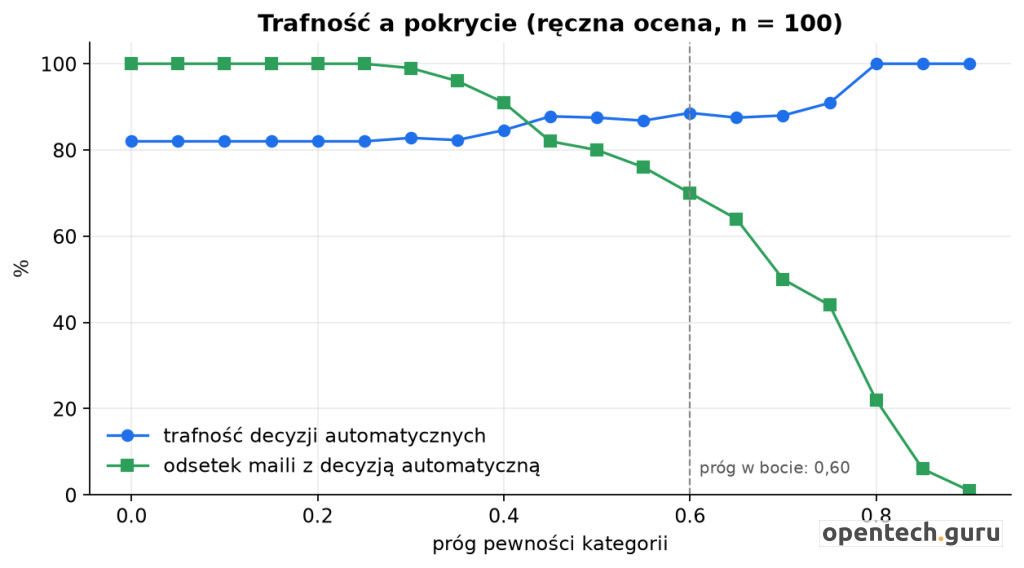
Różnica między skrzynką a archiwum bierze się z rodzaju poczty. W bieżącej skrzynce przeważają alerty, a te Basal rozpoznał bezbłędnie (37 z 37). W archiwum jest więcej zwykłej korespondencji i tam model się myli.
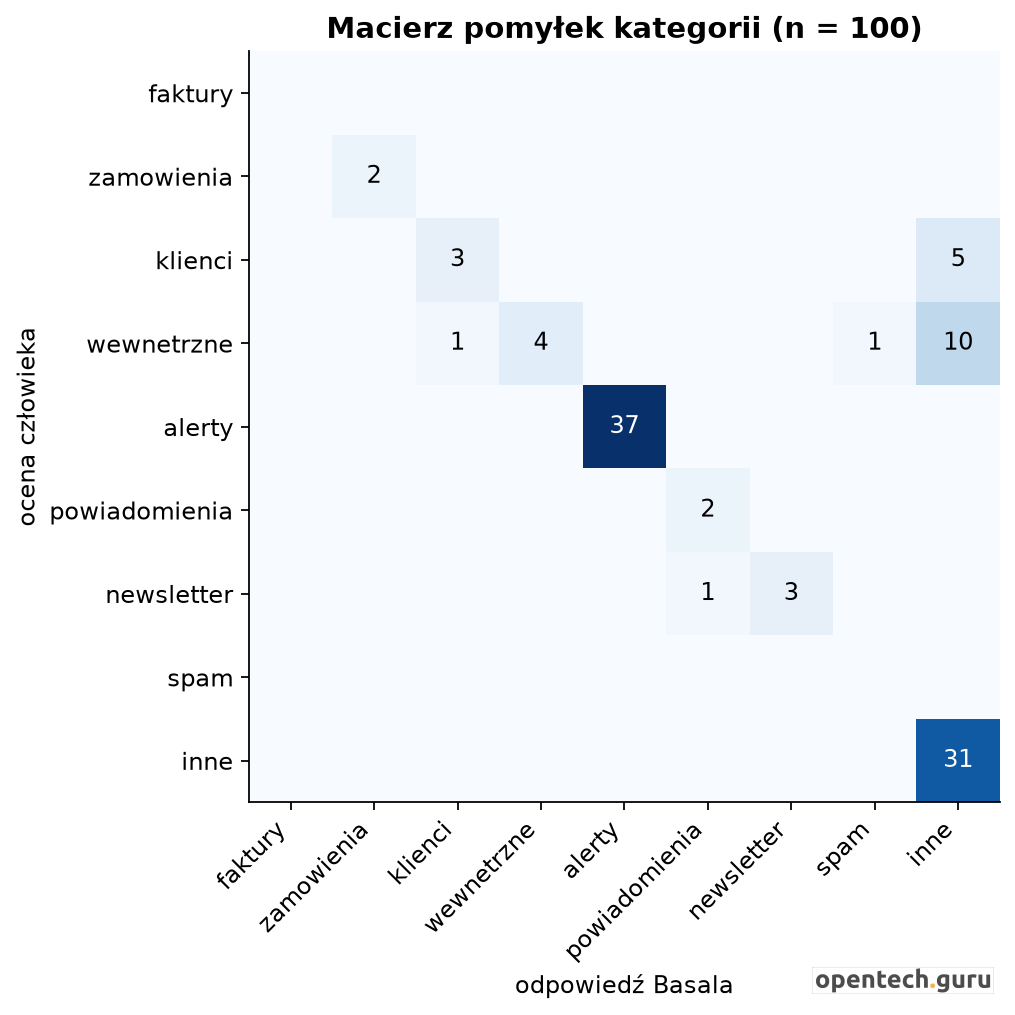
Pomyłki mają jeden wzór: 15 z 18 to wiadomości od współpracowników albo klientów, które Basal wrzucił do „inne”. Model nie wie, kto jest moim współpracownikiem, a kto klientem. Z samej treści „Re: Stopka” nie da się tego wywnioskować. Dlatego ta wiedza jest w kodzie: 13 z tych 15 maili i tak dostaje etykietę kk-pracownicy albo kk-klienci na podstawie adresu nadawcy. W praktyce źle opisane zostały więc 3 wiadomości ze 100.
Pytanie „wymaga działania” nie zadziałało. Ręcznie oznaczyłem 40 maili jako wymagające mojej reakcji. Basal nie dał żadnemu z nich prawdopodobieństwa powyżej 0,25 (mediana 0,03), a mailom niewymagającym działania dawał podobne wartości. Zdolność rozróżniania (AUC) wyniosła 0,40, czyli tyle, co rzut monetą, a nawet trochę gorzej. Przy progu 0,70 „trafność” wyniosła 60%, ale tylko dlatego, że bot nie oznaczył niczego, a 60% maili rzeczywiście nie wymagało działania. Większość „moich” maili do działania to zwykła korespondencja z archiwum, którą Basal opisał jako „inne”. Pytanie o to, czy ja mam coś zrobić, wymaga wiedzy o mojej roli, której mały model nie ma.
Pomiar, potem reguła. Pierwszy pomysł brzmiał „mail do mnie z pytaniem albo prośbą”. Zanim napisałem kod, sprawdziłem na tych samych 100 mailach, co przewidują poszczególne sygnały. Wynik mnie zaskoczył: pytanie lub prośba w treści występowały w 10 z 36 maili „do zrobienia” i w 9 z 27 pozostałych, czyli prawie nic nie wnosiły. Wśród moich maili „do zrobienia” było mnóstwo krótkich odpowiedzi w wątkach: „Dostęp jest, Windows jest.”, „Możecie działać.”. Nie ma w nich pytania, ale są dla mnie ważne. Najmocniejsze okazały się dwa inne sygnały: odpowiedź na mój mail (13 z 36 maili „do zrobienia” i tylko 3 z 27 pozostałych) oraz notatka do siebie (4 z 4).
| Metoda | oznaczone | trafne | fałszywe | złapane z 40 |
|---|---|---|---|---|
| Basal, P(wymaga działania) ≥ 0,70 | 0 | 0 | 0 | 0 |
| mail do mnie + człowiek + pytanie w treści | 9 | 7 | 2 | 7 |
| notatka do siebie lub odpowiedź na mój mail lub mail do mnie od pracownika/klienta | 28 | 23 | 5 | 23 |
Ostatni wariant wdrożyłem w wersji 0.3.0. Flagę dostają tylko notatki do siebie i odpowiedzi na moje maile, a mail do mnie od współpracownika sam etykietę. Fałszywe alarmy to wątki, w których byłem w kopii i nic nie musiałem robić. Zastrzeżenie: warianty porównywałem na tej samej próbce, na której je dobierałem, więc w codziennym użyciu wynik będzie trochę gorszy. Kontrolą będzie świeża próbka. Odpowiedź Basala na to pytanie nadal zapisuję w logu, żeby za kilka tygodni porównać obie metody na nowych mailach.
Cztery maile, które oznaczyłem jako „do zrobienia”, to alerty sprzętowe (wentylator w serwerze, błędy interfejsu sieciowego). Nie złapie ich ani reguła „od człowieka”, ani Basal. To osobna klasa i osobna reguła na przyszłość.
Wydajność na Tesli T4
Czas odpowiedzi zmierzyłem na 80 wiadomościach z bieżącej skrzynki, wysyłając zapytania jedno po drugim, a potem równolegle.

- 5 pytań: mediana 0,62 s, najszybciej 0,35 s. 1 pytanie: mediana 0,19 s. Pięć pytań kosztuje więc około 3 razy więcej niż jedno, a nie 5 razy. Prawdopodobnie dlatego, że wspólny początek zapytania, czyli treść maila, serwer przetwarza raz i trzyma w pamięci podręcznej, a dokładane są tylko krótkie pytania. Tego mechanizmu nie sprawdzałem.
- Czas silnie zależy od długości tekstu. Krótkie alerty (do 700 znaków) zajmują 0,4–0,7 s, a maile ucięte do limitu 4000 znaków nawet 4,7 s. To zakłócało pomiar „po kolei”: 90. percentyl wyniósł 4,6 s.
- Przepustowość: 101 maili na minutę przy jednym zapytaniu naraz, 137/min przy czterech, a przy ośmiu spadek do 123/min. Karta się nasyca, bo Ollama obsługuje w tej konfiguracji dwa zapytania na model równolegle, a reszta czeka w kolejce.
Przy około 60 mailach dziennie GPU pracuje dla bota mniej niż minutę na dobę. Przebieg po całym archiwum (1947 maili, 4 równoległe zapytania) trwał 73 minuty, czyli około 27 maili na minutę, pięć razy wolniej niż w pomiarze. Złożyły się na to dłuższe maile w archiwum (więcej tekstu to dłuższa odpowiedź) i operacje IMAP: pobranie treści i zapis etykiet każdej wiadomości.
Uwaga do pomiaru: w drugiej serii (1 pytanie) do modelu trafiały te same maile co w pierwszej, więc nie wykluczam, że część zysku pochodzi z pamięci podręcznej serwera.
Czego się nauczyłem
Najpierw kod, potem model. Wszystko, co da się rozstrzygnąć adresem, identyfikatorem albo stałym wzorcem, załatwia reguła. Model zajmuje się resztą, w której przydaje się jego „intuicja”.
Model ma prawo nie wiedzieć. Etykieta kk-niepewne to zaleta tego podejścia: zamiast zgadywać, bot przyznaje, że nie wie. Model generatywny zwykle wybrałby coś pewnym tonem.
Akcje nieodwracalne wymagają wysokiego progu i bezpiecznika. Kosz zamiast trwałego usunięcia, migawka flag przed każdą masową operacją, kolejka z ponawianiem zamiast porzucania wiadomości przy przekroczeniu czasu.
Zapisuj wszystko. Bot zapisuje dla każdej decyzji pełne odpowiedzi Basala z prawdopodobieństwami. Dzięki temu progi można stroić na prawdziwych danych, a wszystkie wykresy w tym tekście powstały z tych zapisów.
Najgroźniejszy błąd nie dotyczył modelu. Przy analizie archiwum wyszło, że 209 z 2156 wiadomości (9,7%) bot w ogóle pominął. Biblioteka MIME nie miała zarejestrowanych kodowań znaków, więc wiadomości w iso-8859-2 (191), windows-1250 (15) i kilku innych odrzucała po cichu. W bieżącej skrzynce dotyczyło to 4 z 202 maili. Poprawka to jedna linia importu w Go (_ "github.com/emersion/go-message/charset"), ale bez dokładnego policzenia „ile weszło, ile wyszło” nikt by tego nie zauważył. W polskiej poczcie sprzed kilku lat to wcale nie margines. Po poprawce bot sklasyfikował pominięte wiadomości: 209 w archiwum w niecałe 6 minut, bez błędów, i 4 w bieżącej skrzynce. Wykresy w tym tekście pokazują stan sprzed poprawki (1947 maili z archiwum).
Cichych błędów było więcej. Dopiero zapytanie o regułę, która „nie działała”, odsłoniło dwa kolejne. Po pierwsze, bot pyta serwer o nowe maile zakresem UID n:*. Według standardu IMAP gwiazdka oznacza „największy istniejący UID”, więc gdy nowej poczty nie ma, zakres obejmuje… ostatni mail. Bot obsługiwał go od nowa co dwie minuty, aż przyszła nowa poczta: w logu uzbierało się około 12,8 tysiąca zbędnych wpisów. Po drugie, zamiana HTML na tekst wstawiała spację w miejsce każdego znacznika. Z <b>Osoba:</b> Jan robiło się „Osoba:␣␣Jan”, więc reguła „treść zawiera «Osoba: Jan»” nie mogła zadziałać. Oba błędy naprawia kilka linii kodu. Oba były niewidoczne, dopóki nie zestawiłem tego, co bot zrobił, z tym, co powinien był zrobić.
Ograniczenia tego badania. To jedna skrzynka jednej osoby, w jednej firmie IT, z dużą przewagą alertów. Kategorie dobrałem do swoich potrzeb. Porównanie wariantów opisów korzystało z wzorca opartego na nadawcy, a nie z ręcznej oceny. Pomiary czasu dotyczą karty współdzielonej z innymi modelami, więc w innej konfiguracji wyniki mogą być inne.
Etykiety w Betterbirdzie i Thunderbirdzie
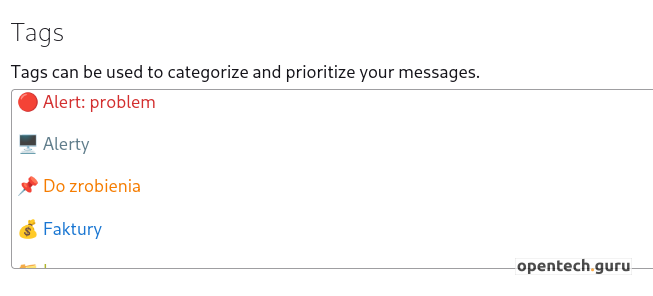
Bot zapisuje etykiety jako słowa kluczowe IMAP. Thunderbird i Betterbird pokazują słowo kluczowe jako kolorowy tag dopiero wtedy, gdy w profilu istnieje tag o tym samym kluczu. Nie warto tworzyć tagów przyciskiem „Dodaj” w ustawieniach, bo program sam wygeneruje klucz z nazwy i nie będzie on pasował do kk-alerty. Najpewniej zdefiniować je w pliku user.js w katalogu profilu:
// >>> KKMailBot tags
user_pref("mailnews.tags.kk-alert-problem.tag", "🔴 Alert: problem");
user_pref("mailnews.tags.kk-alert-problem.color", "#D32F2F");
user_pref("mailnews.tags.kk-alert-ok.tag", "🟢 Alert: OK");
user_pref("mailnews.tags.kk-alert-ok.color", "#388E3C");
user_pref("mailnews.tags.kk-do-zrobienia.tag", "📌 Do zrobienia");
user_pref("mailnews.tags.kk-do-zrobienia.color", "#F57C00");
user_pref("mailnews.tags.kk-pilne.tag", "⚡ Pilne");
user_pref("mailnews.tags.kk-pilne.color", "#C2185B");
user_pref("mailnews.tags.kk-spotkania.tag", "📅 Spotkania");
user_pref("mailnews.tags.kk-spotkania.color", "#0288D1");
user_pref("mailnews.tags.kk-pracownicy.tag", "👥 Pracownicy");
user_pref("mailnews.tags.kk-pracownicy.color", "#00897B");
user_pref("mailnews.tags.kk-alerty.tag", "🖥️ Alerty");
user_pref("mailnews.tags.kk-alerty.color", "#607D8B");
user_pref("mailnews.tags.kk-faktury.tag", "💰 Faktury");
user_pref("mailnews.tags.kk-faktury.color", "#1976D2");
user_pref("mailnews.tags.kk-klienci.tag", "🤝 Klienci");
user_pref("mailnews.tags.kk-klienci.color", "#7B1FA2");
user_pref("mailnews.tags.kk-niepewne.tag", "❓ Niepewne");
user_pref("mailnews.tags.kk-niepewne.color", "#FBC02D");
// ... pozostałe kategorie analogicznie
// <<< KKMailBot tags
Procedura:
- Znajdź używany profil: Pomoc → Informacje dla pomocy technicznej → Folder profilu. Betterbird potrafi pracować na profilu Thunderbirda (
~/.thunderbird/…), więc nie zakładaj, że profil leży w~/.eu.betterbird. - Zamknij program. Thunderbird nadpisuje pliki profilu przy zamykaniu.
- Dopisz blok do
user.js(utwórz plik, jeśli go nie ma). Znaczniki>>>i<<<pozwalają później podmienić blok jednym poleceniemsed. - Uruchom program i włącz kolumny Tagi i Gwiazdka. Pasek Szybki filtr → Tagi pozwala pokazać na przykład tylko 🔴 problemy (zobacz na zdjęciu poniżej).
user.js jest wczytywany przy każdym starcie, więc nazwy i kolory zmienia się w tym pliku, a nie w Ustawieniach. Jeśli tagi są już zdefiniowane, a stare wiadomości wciąż nie mają kolorów, pomaga Właściwości folderu → Napraw folder.
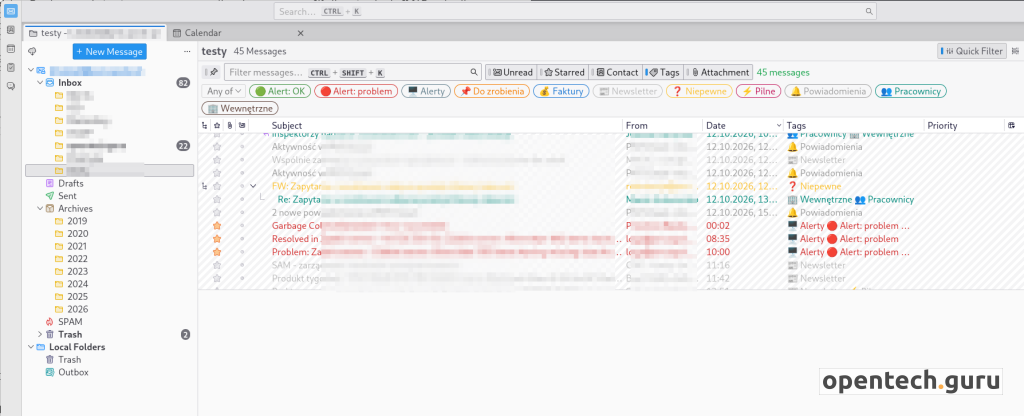
Przydatny jest też folder wyszukiwania „Moje sprawy”: Odebrane, warunek „Tagi zawierają 📌 Do zrobienia” lub „Tagi zawierają ⚡ Pilne”. Mam w nim kilka wiadomości zamiast kilkuset.
Na deser: co jeszcze potrafi lokalny LLM
Basal podejmuje decyzje, ale nie pisze. Na tej samej karcie T4 działają jednak modele czatowe (Bielik 11B i Qwen 2.5 7B), więc naturalne kolejne kroki to:
- Streszczenie długiego wątku w trzech zdaniach, dopisane do maila oznaczonego jako „do zrobienia”.
- Szkic odpowiedzi w folderze Wersje robocze. Wysłanie zawsze zostaje przy człowieku.
- Poranny raport alertów: zamiast 200 maili od Zabbixa jeden akapit z listą trwających problemów i tym, co się rozwiązało w nocy.
- Wyciąganie danych z faktur (kontrahent, kwota, termin płatności) do arkusza albo systemu księgowego.
- Pytania do archiwum („kiedy ostatnio wymienialiśmy dysk w tym serwerze?”) przez wyszukiwanie semantyczne po etykietowanej poczcie.
Podział ról zostaje ten sam: kod tam, gdzie odpowiedź jest znana, Basal tam, gdzie trzeba szybko i tanio zdecydować, a duży model tam, gdzie trzeba coś napisać.